Agenti AI nella cybersecurity, i test attuali non bastano
 Redazione SecurityOpenLab
Nel test più vicino al lavoro di un analista il miglior modello AI ottiene 0,368 su 1, e un agente può dare il verdetto giusto con le prove sbagliate


Nello sviluppo degli agenti per la security oggi prevale la tendenza a costruire in fretta un prototipo e a occuparsi solo dopo della valutazione, portando così a ottenere sistemi fragili e difficili da correggere. Il giusto modo di procedere sarebbe progettate l’agente AI destinato al SOC partendo dal modo in cui sarà valutato, e trasformando in un caso di test ogni errore emerso in produzione. Lo sostiene SentinelOne in un post sul blog ufficiale, sottolineando che l’importanza di poter distinguere un dato solido da uno che regge solo sulla carta. C'è poi il tema delle persone. Secondo gli autori il metro di giudizio per gli agenti deve venire da analisti esperti, cioè dalle figure che il mercato fatica a trovare: ricordiamo infatti che nei Paesi del G7, Italia compresa, la quota di annunci di lavoro in cybersecurity che chiedono competenze AI è passata dal 14,2% al 28,5%.
L'analisi di SentinelLabs ha passato in rassegna quattro benchmark standard con cui si confrontano diffusamente le prestazioni dei modelli: ExCyTIn-Bench di Microsoft, CyberSOCEval e CyberSecEval 3 di Meta e CTIBench del Rochester Institute of Technology. La conclusione di SentinelLabs è che nessuno di questi test misura ciò che serve davvero a un SOC, cioè rilevare un attacco il prima possibile, contenerlo più in fretta possibile e decidere meglio sotto pressione. I benchmark valutano compiti isolati, spesso con domande a risposta multipla, anziché il flusso continuo di un’indagine. Nell’analisi del malware i modelli sbagliano la maggior parte delle risposte e il risultato è che un buon punteggio in questi test non dice a un’azienda se un sistema basato su LLM migliorerà la sua sicurezza.
Per gli autori, un agente costruito come un’unica catena di elaborazione funziona finché qualcosa nell’ambiente non cambia, e a quel punto è difficile capire dove intervenire. Modello e prompt si sostituiscono con relativa facilità; molto più complicato è aggiungere a posteriori la possibilità di rispondere a due domande, cioè se il sistema funziona e, in caso contrario, che cosa modificare per migliorarlo. Le linee guida sulla valutazione degli agenti pubblicate da Anthropic e da OpenAI, citate nel post, vanno nella stessa direzione.
Fra il dire e il fare
Gli esperti chiariscono che un tasso di precisione calcolato sui soli verdetti, anche molto alto, dice poco su come l’agente ci è arrivato. Gli autori fanno l’ipotesi di un agente che concorda con gli esperti nel 95% dei casi e che potrebbe limitarsi a riconoscere le caratteristiche ricorrenti degli alert, senza aver raccolto le prove. Propongono poi l’esempio di un’indagine che si chiude con il verdetto corretto anche se la query al SIEM ha usato l’identificativo di dispositivo sbagliato e ha recuperato eventi estranei al caso. In entrambi i casi si parla comunque di un fallimento, perché un verdetto che non poggia sulle prove non offre garanzie quando qualcosa nell’ambiente cambia. Il limite si lega alla più ampia questione dell’affidabilità dell’AI agentica, per la quale metriche come l’accuratezza non bastano a prevedere il comportamento di un sistema in situazioni impreviste.
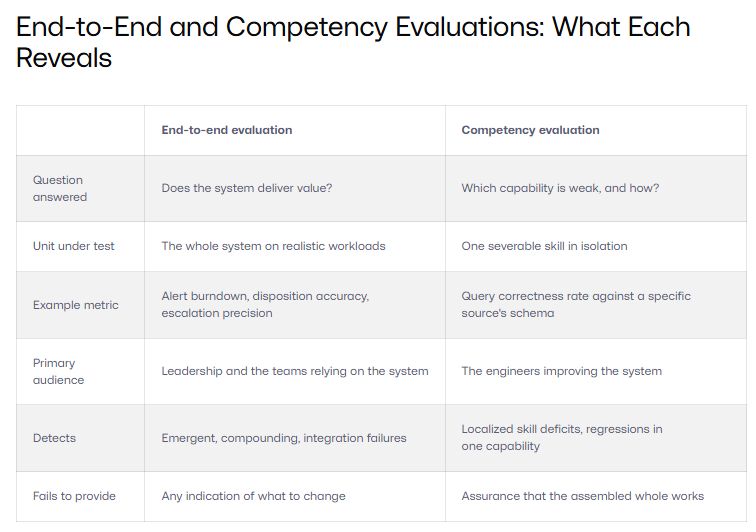
Secondo il post, le metriche di sistema valide sono la quota di lavoro che resta agli analisti, la percentuale di verdetti che coincidono con quelli stabiliti dagli esperti, il tempo necessario per arrivare a una conclusione, la stabilità e la coerenza dei risultati fra un’esecuzione e l’altra e il costo per alert. Oltre a queste servono poi test separati per ogni competenza dell’agente, che per un’indagine vanno dalla formulazione delle ipotesi alla scrittura delle query, dalla conoscenza del significato dei campi nei log alla scelta del passo successivo, fino al giudizio su quando le prove sono sufficienti, perché un dato aggregato segnala che qualcosa è peggiorato senza dire che cosa.
Passiamo alla linea del tempo: un agente AI dipende da un modello linguistico, da prompt, da strumenti e da flussi di lavoro che cambiano spesso, e ogni modifica può reintrodurre errori già corretti. Gli autori si chiedono come farebbe un team, dopo aver scoperto e risolto un difetto nella logica delle query, a sapere che il successivo aggiornamento del modello o dell’infrastruttura non lo ha riportato. La risposta è conservare ogni errore corretto nella batteria di test e confrontare ogni nuova versione con la precedente. Senza questa disciplina, ricorda il post citando le linee guida di Anthropic, gli utenti si accorgono soltanto che l’agente sembra funzionare peggio dopo un cambiamento, e il team non riesce a distinguere un peggioramento reale da una normale oscillazione dei risultati. Per chi acquista agenti come servizio ne deriva che la valutazione fatta al momento della scelta ha una durata limitata, e che conviene chiedere al fornitore come controlla le regressioni, cioè il ritorno di errori già risolti, a ogni rilascio.
Il post offre anche una chiave per capire dove guardare. La parte più visibile del lavoro di un agente è il resoconto che presenta all’analista, ed è anche la meno indicativa, perché i modelli attuali riassumono bene quasi qualsiasi testo. Gli errori che pesano stanno più a monte: nelle query con cui l’agente interroga i dati. Lì lo sbaglio è oggettivo, si propaga a tutta l’indagine e i modelli sono notoriamente deboli con la sintassi propria di ogni linguaggio di interrogazione e di ogni schema di dati. Una query sbagliata può girare senza errori e restituire dati plausibili, per cui l’analista che legge un resoconto ben scritto non ha modo di accorgersene.
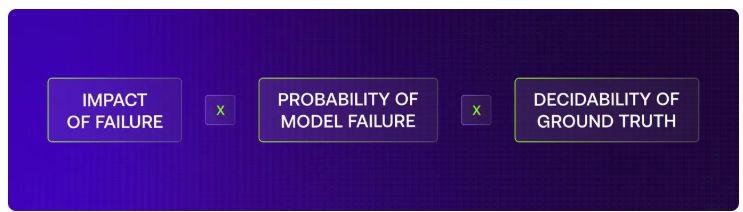
Nel caso dell’identificativo sbagliato, un test dedicato fornirebbe all’agente un alert con l’identificativo di un dispositivo e verificherebbe che la query recuperi esattamente gli eventi di autenticazione attesi, trasformando un difetto nascosto dentro un’indagine riuscita in un errore misurabile. Gli autori suggeriscono di concentrare i test dove si sommano tre fattori: l’impatto di un errore, la probabilità che il modello sbagli e la possibilità di stabilire con certezza la risposta giusta. Ogni caso andrebbe giudicato con un esito binario, più facile da applicare in modo coerente rispetto a un voto di qualità.
Tag correlati
Esplora altri articoli su questi argomenti
Se questo articolo ti è piaciuto e vuoi rimanere sempre informato
Notizie correlate
Speciali Tutti gli speciali
Calendario Tutto
Ultime notizie Tutto
Cybersecurity nell’era dell’AI: nuove sfide, nuove opportunità
03-11-2026
Agenti AI nella cybersecurity, i test attuali non bastano
03-11-2026
Industria OT: solo il 12% ha mappato i rischi fisici dell'AI
02-11-2026
Check Point MHO 200 protegge app AI, LLM, agenti e server MCP
02-11-2026
G11 Media Networks

SecurityOpenLab e' un canale di BitCity, testata giornalistica registrata presso il tribunale di Como ,
n. 21/2007 del
11/10/2007- Iscrizione ROC n. 15698
G11 MEDIA S.R.L.
Sede Legale Via NUOVA VALASSINA, 4 22046 MERONE (CO) - P.IVA/C.F.03062910132
Registro imprese di Como n. 03062910132 - REA n. 293834 CAPITALE SOCIALE Euro 30.000 i.v.
